Uma integração que falha nem sempre precisa de intervenção imediata. Uma conexão pode cair por instantes e funcionar na tentativa seguinte. O problema é repetir qualquer erro, sem limite e sem conferir o efeito anterior. Em vez de recuperar a operação, a integração ocupa recursos e pode multiplicar registros no destino.
Imagine uma empresa fictícia que envia pedidos aprovados para um ERP. Em um momento de instabilidade, parte das chamadas termina sem resposta. A equipe precisa decidir quais pedidos podem ser tentados novamente, quais exigem conferência e como retomar o trabalho quando o serviço voltar.
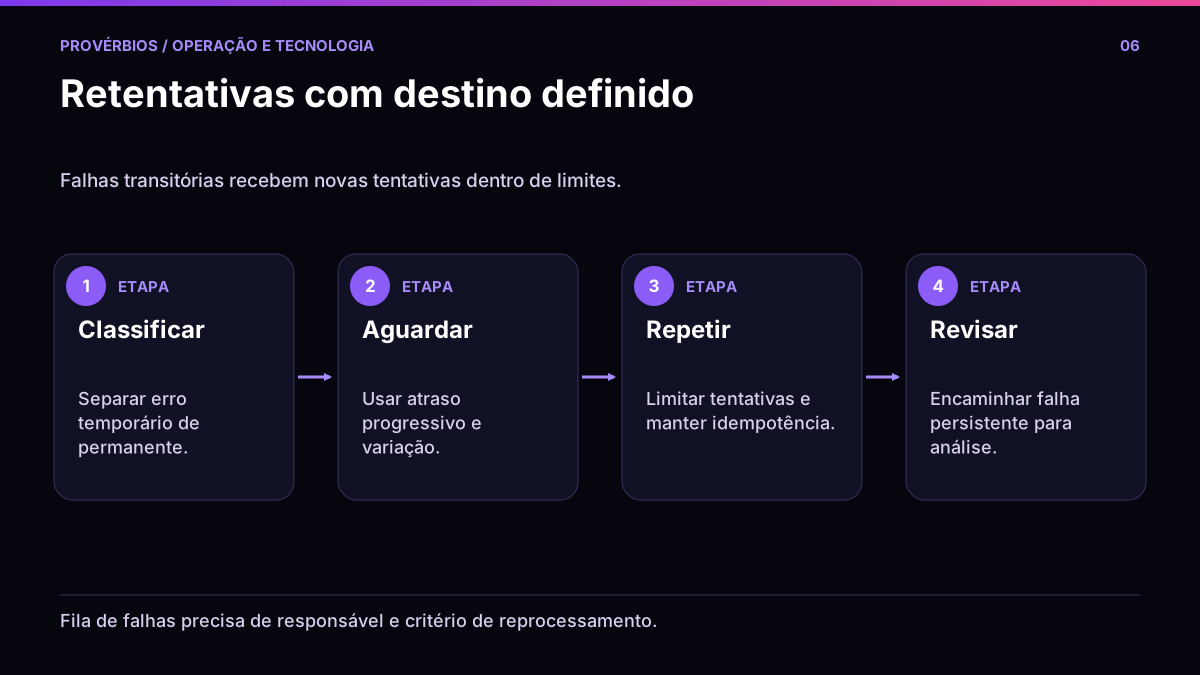
Classifique a falha antes de repetir
| Situação | Ação sugerida | Conferência necessária |
|---|---|---|
| Conexão indisponível | Nova tentativa limitada | Verificar se houve efeito anterior |
| Limite de requisições | Reduzir cadência e respeitar orientação do serviço | Examinar resposta e limite documentado |
| Campo obrigatório ausente | Enviar para correção | Validar o contrato do dado |
| Credencial recusada | Pausar o consumidor e acionar responsável | Conferir acesso, validade e configuração |
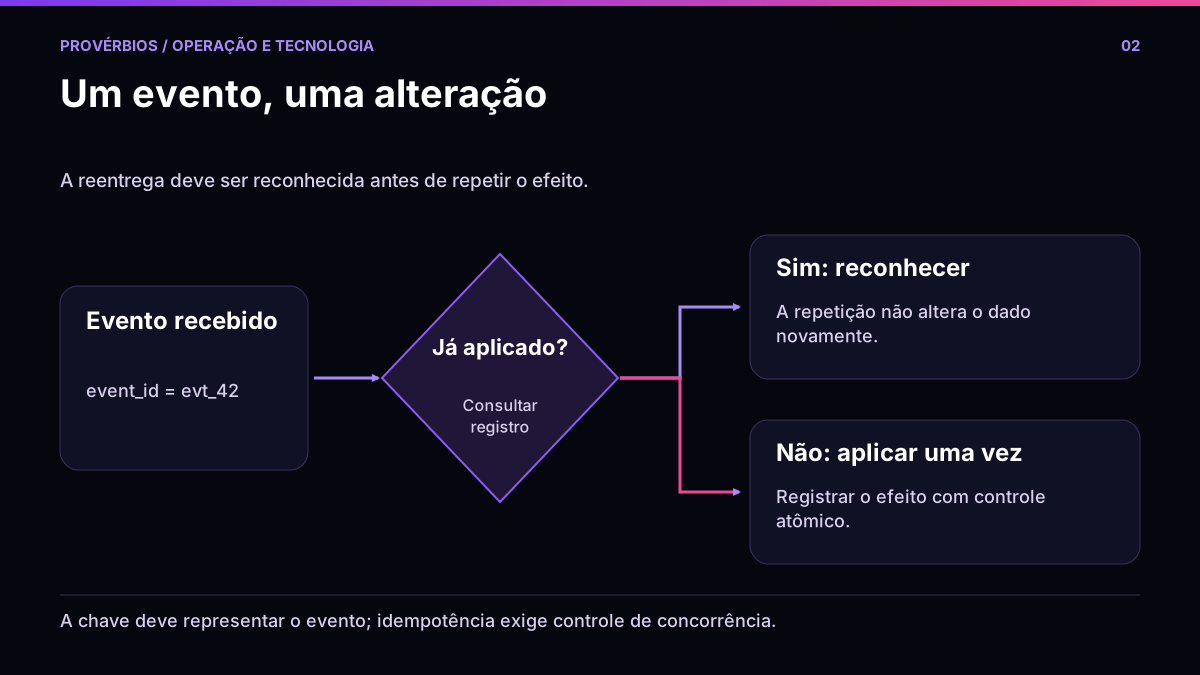
A tabela é um ponto de partida. O significado exato dos códigos e a possibilidade de repetição dependem da API. Uma resposta de erro não prova que nada foi gravado. Se o pedido pode ter sido criado antes de a comunicação falhar, consultar a referência externa ou usar uma chave de idempotência pode ser necessário.
Espaçe as tentativas e estabeleça um teto
Em vez de repetir imediatamente, introduza uma espera. Um exemplo didático seria esperar aproximadamente um segundo, depois dois, quatro e oito, sempre com limite máximo e pequena variação aleatória. Esses números não são uma configuração recomendada para toda operação: precisam considerar o destino, a urgência e a documentação disponível.
A referência da AWS sobre timeouts e retentativas explica como espera progressiva e variação aleatória, conhecida como jitter, ajudam a evitar que clientes voltem a pressionar um serviço ao mesmo tempo. Ela também discute o risco de repetir operações com efeitos colaterais e de ampliar sobrecarga.
Defina quantidade máxima de tentativas, idade máxima do trabalho e tempo máximo de cada chamada. Uma integração de consulta pode tolerar espera diferente de uma operação que bloqueia o fechamento do pedido. O responsável pelo processo precisa participar da escolha, para que a configuração técnica reflita o prazo realmente necessário.
Evite retentativas em várias camadas
Biblioteca HTTP, trabalhador da fila e aplicação podem repetir a mesma chamada sem que a equipe perceba. Se cada camada fizer várias tentativas, o total cresce rapidamente. Registre qual camada controla a recuperação e desative ou ajuste as demais conforme o desenho escolhido.
Também limite a concorrência. Quando o destino se recupera, milhares de trabalhos acumulados não devem ser liberados de uma vez. A fila precisa drenar em uma cadência que o serviço consiga suportar. Observe erros e atrasos durante essa recuperação, e reduza a vazão se a instabilidade reaparecer.
Faça a fila de falhas chegar a alguém
Uma fila de falhas guarda trabalhos que esgotaram as tentativas ou precisam de correção. Ela deve registrar o identificador do trabalho, a referência do objeto, a categoria do erro, os horários e as tentativas. Evite guardar senhas, tokens ou dados pessoais desnecessários apenas para facilitar o diagnóstico.
No exemplo do ERP, o pedido P-320 pode ter sido rejeitado por ausência de código do produto. O responsável corrige o mapeamento, confirma que o pedido ainda não existe no destino e autoriza a repetição daquele trabalho. Corrigir a causa deve vir antes de pressionar um botão que reenvia toda a fila.
Teste recuperação e encerramento
Simule uma falha transitória, uma rejeição definitiva e uma resposta perdida após processamento. Confira o número de tentativas, os intervalos, o destino final do trabalho e a quantidade de efeitos produzidos. O caso só termina quando o resultado comercial foi reconciliado ou a exceção recebeu uma decisão registrada.
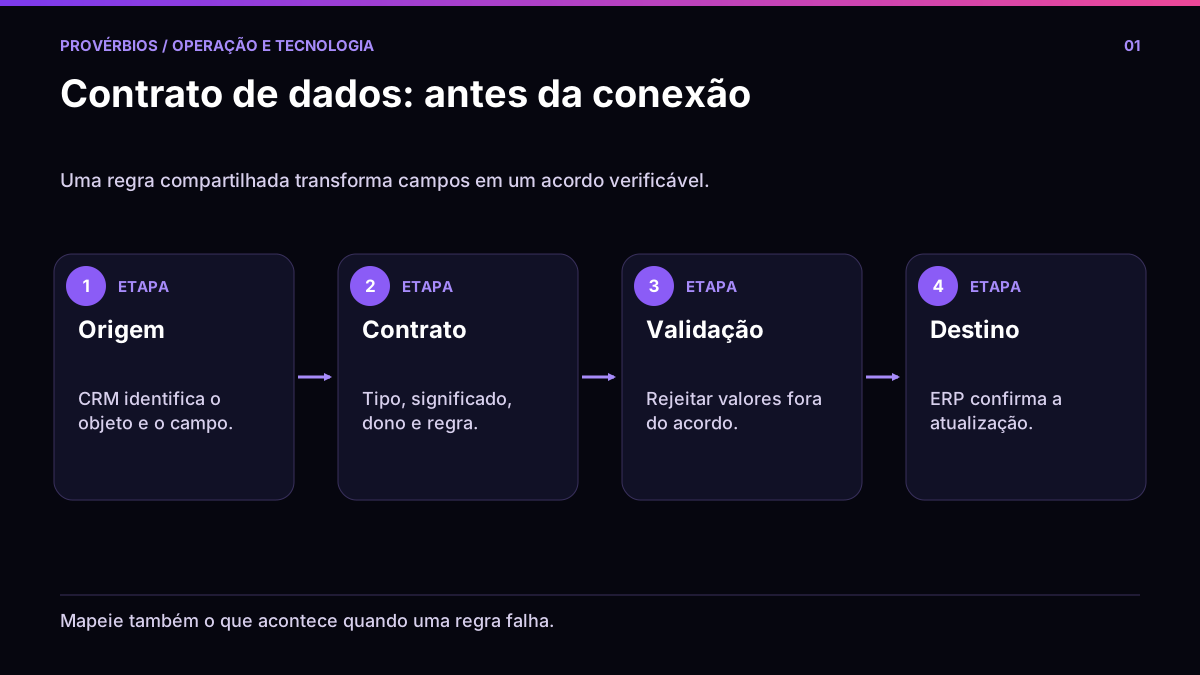
Use a mesma identificação definida no contrato de dados e trate repetições conforme o desenho de idempotência. Uma boa política de retentativas permite que a equipe explique o caminho de cada falha até a recuperação, sem perder trabalhos nem repetir efeitos indevidamente.
Fontes e referências
Referências consultadas em 21/10/2026. Confira a documentação vigente do seu fornecedor antes de alterar uma integração.